دریافت کلید API
پس از ثبتنام، کلید اختصاصی API را از پنل کاربری دریافت کنید.

قدم اول
ارسال درخواست
فایل صوتی را همراه با کلید به آدرس سرویس ارسال کنید.
قدم دوم

محصولات هوشمند سازمانی
AUDIO-API
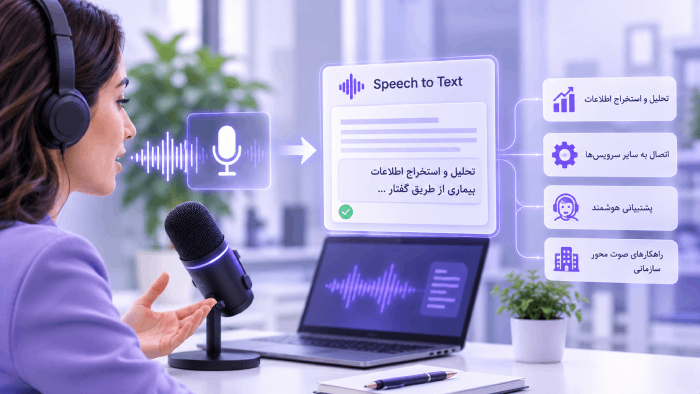
تبدیل گفتار به متن (Speech-To-Text) و پردازش هوشمند اطلاعات صوتی، با قابلیت توسعه راهکارهای صوت محور متناسب با نیاز هر سازمان. این سرویس میتواند به عنوان زیرساختی مشترک برای طراحی و پیادهسازی قابلیتهای هوشمند در بخشهای مختلف سازمان مورد استفاده قرار گیرد.
سرویس آنالیز صوت
سرویس آنالیز صوت هوشمند با بهرهگیری از هوش مصنوعی، جریانهای صوتی زنده و فایلهای ضبطشده را بهصورت خودکار پردازش میکند و رویدادهای مهم را در لحظه شناسایی میکند.
استخراج محتوای گفتار از فایلهای صوتی و مکالمات بدون وابستگی به نظارت انسانی مداوم
دریافت اطلاعات از طریق گفتار و تبدیل آن به دادههای مورد نیاز فرم سازمان
فراهم کردن بستر سرویسهای صوتمحور متناسب با فرآیندها و نیازهای هر سازمان
امکان استفاده از قابلیت پردازش صوت در سامانههای موجود سازمان
تفکیک گویندگان مختلف در یک مکالمه
تشخیص خشم، استرس و تنش در گفتار
مزیتها و کاربردهای سرویس Text To Speech
نحوه استفاده
در سه قدم
دریافت کلید API
ارسال درخواست
دریافت نتیجه
مستندات API
مستندات فنی
// نمونه: استخراج متن از صوت
var body={
user_message:'',//string
agent_uuid:'',//string
model_uuid:'',//string
media_list:''// binary
}
const res = await fetch(
'https://api.ai/core/chat',
{
method: 'POST',
headers: { 'Authorization': 'Bearer YOUR_API_KEY' },
body: body,
}
);
const data = await res.json();
// data.response → متن استخراجشده
آماده شروع هستید؟
کلید API خود را دریافت کنید
ثبت نام کنید، کلید بگیرید و اولین درخواست خود را ارسال کنید.
سوالات متداول
پرسشهای فنی
سرویس از فرمت رایج WAV پشتیبانی میکند. نرخ نمونهبرداری توصیهشده ۱۶ کیلوهرتز یا بالاتر است. در صورت ارسال صدا با نرخهای دیگر، سرویس بهصورت خودکار آن را تبدیل میکند.
در حالت پردازش زنده، تأخیر معمول از لحظه دریافت صدا تا اعلام نتیجه کمتر از یک ثانیه است و این مقدار به تعداد کانالها و منابع سختافزاری بستگی دارد. دقت مدلها بر اساس دادههای واقعی و محیطهای پرنویز ارزیابی میشود و حد آستانه حساسیت برای هر نوع رویداد صوتی قابل تنظیم است تا تعادل مناسب بین هشدار اشتباه و تشخیصهای از دسترفته برقرار شود.
یکپارچهسازی از طریق REST API و WebSocket انجام میشود. رویدادهای شناساییشده بهصورت JSON شامل نوع رویداد، زمان دقیق، میزان اطمینان و شناسه منبع صوتی ارسال میشوند. همچنین امکان دریافت رویدادها از طریق وبهوک یا صف پیام مانند Kafka وجود دارد تا اتصال به پلتفرمهای نظارتی و سامانههای هشدار بهسادگی انجام شود.
سرویس هم بهصورت سازمانی روی زیرساخت داخلی (On-Premise) و هم روی بستر ابری قابل استقرار است. ارتباطات با TLS رمزنگاری میشود و دادههای ذخیرهشده با رمزنگاری سمت سرور محافظت میشوند. دسترسیها بر پایه نقشها کنترل میشود و مدت نگهداری فایلها قابل تنظیم است؛ همچنین میتوان پردازش را بهگونهای تنظیم کرد که صدا پس از تحلیل ذخیره نشود و فقط نتیجه تحلیل باقی بماند.
نیاز سازمانتان را با ما در میان بگذارید؛ مسیر مناسب هوشمندسازی را با هم ترسیم میکنیم.
راه های ارتباطی
محصولات
لینک های مهم